Reorganizando los revisores y los roles de dev-orchestra
Introducción
La vez anterior comparé los presets de dev-orchestra. Un preset decide de una sola vez “en qué gastar el dinero en toda la máquina”.
Esta vez explico cómo reorganizar su contenido por tu cuenta.
- Qué CLI y qué modelo usar en cada rol
- Cuántos revisores, y con qué enfoques, poner en fila
- Pedirle a
config suggest-rolesque proponga especialistas de dominio adaptados al repositorio
Al final, le mostré a 9 revisores un cambio con bugs plantados a propósito y medí qué cambia al aumentar su número.
Todo lo de esta entrada lo comprobé con dev-orchestra 1.0.0. Para la información más reciente, consulta la documentación de configuración.
dev-orchestra está publicado en GitHub (licencia MIT). Si te parece útil, una estrella me haría mucha ilusión.
Pasos
1. Conocer los roles
dev-orchestra tiene cinco roles.
| Rol | Nombre en la config | Qué hace |
|---|---|---|
| Dirección | orchestrator | Decide qué etapas hacen falta y resume los resultados |
| Diseño | architect | Investiga y escribe un plan (solo lectura) |
| Implementación | implementer | Escribe código y pruebas a partir del plan |
| Revisión | reviewers | Leen el mismo diff sin ver los resultados de los demás (solo lectura). Puedes tener los que quieras |
| Corrección | review_fixer | Corrige solo los hallazgos aceptados en el triaje |
Los cuatro roles distintos de la revisión tienen un agente cada uno, pero de revisores puedes poner los que quieras.
2. Especificar los modelos como “familia + latest”
En la config de dev-orchestra no escribes el nombre del modelo (un ID con fecha). Escribes un nombre de familia y la indicación de “usar la última de esa familia”.
implementer:
  provider: claude
  model:
    family: opus        # nombre de la familia
    version: latest     # la última de esa familia
Así, cuando sale un modelo nuevo, lo sigue sin que cambies la config. En cada ejecución consulta al CLI instalado cuál es el último opus antes de usarlo, de modo que nunca crees estar ejecutando con un nombre de modelo que no existe. Si no puede confirmarlo, se detiene en lugar de adivinar.
dev-orchestra model list muestra qué nombres de familia puedes usar. Esto es lo que me salió a mí (extracto).
claude: installed
  fable                        family=fable                source=cli-help
  opus                         family=opus                 source=cli-help
  sonnet                       family=sonnet               source=cli-help
codex: installed
  CLI default (recommended coding model) family=recommended-coding   source=cli-default
  GPT-6.1-Sol                  family=gpt-6.1-sol          source=cli-catalog
  GPT-6-Astra                  family=gpt-6-astra          source=cli-catalog
Si de verdad necesitas fijar un único modelo, puedes escribir
version: pinnedcon un ID. Pero dejará de seguir a los modelos nuevos, así que úsalo solo a propósito.
3. Cambiar el CLI o el modelo por rol
La forma más fácil de reorganizar es pedírselo al agente. Por detrás se ejecutan comandos como estos.
| Lo que pides | Comando que se ejecuta |
|---|---|
| “Usa opus de Claude para la implementación” | config set implementer.model.family opus |
| “Que Codex se encargue del diseño” | config set architect.provider codex (+ un nombre de familia que acepte Codex) |
| “Cámbialo solo para este proyecto” | Añade --scope project al comando que escribe |
Los ajustes se aplican en el orden proyecto → global → valores predeterminados integrados. Sobre el preset, solo sobrescribes lo que quieres cambiar.
4. Dar a un rol un modelo más barato y una segunda opinión
Con los model tiers (niveles de modelo) puedes dar a un rol otros modelos como alternativa.
implementer:
  provider: claude
  model:
    family: opus
    version: latest
  model_tiers:
    light:                 # un modelo más barato para cosas como arreglos de una línea
      model:
        family: sonnet
        version: latest
    second-opinion:        # otra pasada con la IA de otra empresa
      provider: codex
El orquestador elige qué nivel usar según la dificultad de la petición (run implementer --tier light).
Si especificas un nivel que no existe, da error; nunca se ejecuta en silencio con el modelo predeterminado.
5. Elegir los enfoques de los revisores
A cada revisor le das un enfoque (role). Aunque el diff sea el mismo, el enfoque cambia lo que mira.
| Enfoque | En qué se fija principalmente |
|---|---|
general | Corrección, casos límite, manejo de errores y demás |
security | Autenticación y autorización, inyección, manejo de secretos |
performance | Complejidad, consultas N+1, I/O innecesaria |
test | Pruebas del comportamiento modificado, aserciones sin sentido |
architecture | Reparto de responsabilidades, acoplamiento, coherencia con las convenciones existentes |
database | Seguridad de las migraciones, bloqueos, restricciones, índices |
frontend | Manejo del estado, renderizado, accesibilidad |
backend | Contratos de la API, validación, códigos de estado |
Así se añaden, quitan y cambian revisores (esto también se lo puedes pedir al agente).
dev-orchestra reviewer add --provider codex --role security   # add a Codex security reviewer
dev-orchestra reviewer set 2 --provider codex --role general  # replace the 2nd one
dev-orchestra reviewer remove performance                     # remove
dev-orchestra reviewer list                                   # check
Con reviewer set <id> --when high-risk también puedes crear un revisor que solo se ejecuta en cambios arriesgados.
6. Pedirle a config suggest-roles que proponga especialistas de dominio
Esta es la función que más quería presentar esta vez.
config suggest-roles mira los nombres de archivo del repositorio y decide si hacen falta especialistas de database, frontend o backend. No llama a ningún modelo, así que no gasta tokens.
Para esta entrada, creé un repositorio de una pequeña app de TODO con un frontend, una API y migraciones de base de datos, y lo probé.
Proposed:
  claude-database  claude / sonnet  role database
    when.paths: migrations/*, */migrations/*, *.sql
    evidence: migrations/: 2 files, e.g. db/migrations/001_create_users.sql, db/migrations/002_create_todos.sql
  claude-frontend  claude / sonnet  role frontend
    when.paths: *.tsx
    evidence: *.tsx: 2 files, e.g. frontend/src/TodoItem.tsx, frontend/src/TodoList.tsx
  claude-backend  claude / sonnet  role backend
    when.paths: api/*, */api/*, routes/*, */routes/*
    evidence: api/: 3 files, e.g. api/db.py, api/routes/todos.py, api/routes/users.py
Each joins only code rounds touching its paths, and every design review round.
Incluso muestra por qué propuso cada uno (evidence).
En cambio, al ejecutarlo en el repositorio de este blog (Astro) no propuso nada.
Not proposed:
  database: no signal (no migrations/, migrate/, alembic/ or prisma/ directory; fewer than 2 *.sql files; no schema.prisma)
  frontend: no signal (fewer than 2 *.tsx, *.jsx, *.vue or *.svelte files)
  backend: no signal (no api/, server/, backend/, handlers/, routes/ or controllers/ directory holding 2 files outside a frontend)
Nothing to add.
También muestra por qué no propuso nada, así que nunca te quedas preguntándote por qué no se añadió.
Para aceptar la propuesta, añade --write. Esto se añadió al archivo de configuración del proyecto (.dev-orchestra.yaml).
reviewers_extra:
  - id: claude-database
    provider: claude
    model:
      family: sonnet
      version: latest
    role: database
    when:
      paths:
        - "migrations/*"
        - "*/migrations/*"
        - "*.sql"
La clave es when.paths. Un especialista se une a las revisiones de código solo cuando cambian archivos de esas rutas. El revisor de database no se llama cuando solo arreglas CSS, así que las revisiones de código de todos los días no se vuelven más pesadas.
Sin embargo, como dice la última línea de la salida, los especialistas se unen a todas las revisiones de diseño. El coste de las revisiones de diseño sube en esa medida.
| Presets | suggest-roles | |
|---|---|---|
| Qué decide | Cómo gastar el dinero en toda la máquina | Añadir especialistas adaptados al repositorio |
| Dónde se guarda | Config global | Config del proyecto |
| Cuándo se aplica | Siempre | Revisiones de código solo cuando cambian esas rutas; revisiones de diseño siempre |
7. Medir qué cambia al aumentar los revisores
Por último, medí cómo cambian los resultados según el número de revisores.
Método
- En la app de TODO anterior, creé un cambio con 6 bugs plantados a propósito (4 archivos)
- Lo revisé una sola vez con 9 revisores: el preset
quality(6 revisores entre Claude y Codex) más los 3 especialistas desuggest-roles - Como los revisores trabajan sin ver los resultados de los demás, los resultados de configuraciones como “solo 1 revisor” o “2 empresas” los conté combinando los resultados de los 9
- Hice yo mismo el triaje de todos los hallazgos y los separé en los bugs plantados (B1 a B6) y los problemas reales que no había plantado (E1 a E6)
| Bug plantado | |
|---|---|
| B1 | Inserta el término de búsqueda en el SQL con un f-string (inyección SQL) |
| B2 | El borrado no comprueba el propietario (se puede borrar el TODO de otra persona) |
| B3 | + 1 en el offset de la paginación (se desplaza un elemento) |
| B4 | Añade una columna NOT NULL sin valor por defecto (la migración falla) |
| B5 | Muestra el título con dangerouslySetInnerHTML (XSS) |
| B6 | La prueba de borrado no verifica la comprobación del propietario |
Resultados
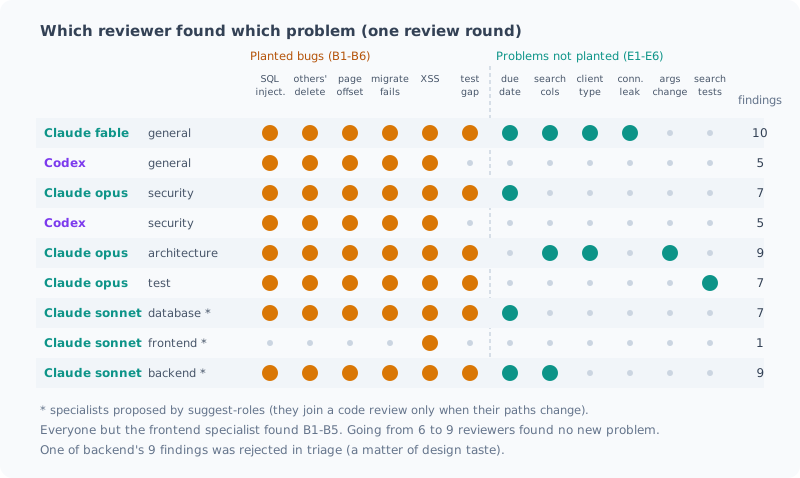
Agrupado por configuración, salió así.
| Configuración | Problemas encontrados (de 12) | Hallazgos (antes de fusionar duplicados) |
|---|---|---|
| Claude fable (general) solo | 10 | 10 |
| Codex (general) solo | 5 | 5 |
| 2 empresas (los 2 anteriores) | 10 | 15 |
Los 6 de quality | 12 | 43 |
| 6 + 3 especialistas | 12 | 60 |
Lo que aprendí
- Los bugs evidentes los encontraron casi todos. B1 a B5 los encontraron los 8 revisores salvo el especialista de frontend (cuyo enfoque es el frontend)
- Pasar de 2 a 6 revisores encontró 2 problemas más (10 → 12). Los 2 añadidos fueron E5 y E6
- Pasar de 6 a 9 no añadió problemas, solo hallazgos. Los 6 encontraron los 12, y con 9 los hallazgos pasaron de 43 a 60. Después de que dev-orchestra fusionara los duplicados, los 60 quedaron en 51
- La diferencia apareció en los problemas no plantados. “Cambian los argumentos de una función y se rompen sus llamadores” (E5) lo encontró solo el enfoque architecture, y “no hay pruebas de la búsqueda” (E6) solo el enfoque test
- La diferencia entre modelos también fue grande. Con el mismo enfoque general, Claude fable solo encontró 10 de los 12, mientras que Codex encontró 5. En esta ejecución no pude separar el efecto del modelo del efecto del enfoque
- Los 2 revisores de Codex encontraron 5 de los bugs plantados sin falsos positivos, pero en esta ejecución no plantearon ningún problema que los demás no vieran
- El coste de los 9 fue de unos 110.000 tokens en total (porque el diff era pequeño, de solo 4 archivos)
Este es el resultado de una sola ejecución con una muestra pequeña. Los bugs plantados eran todos evidentes, y considerar “reales” los problemas no plantados fue decisión mía. En cambios más complejos del desarrollo real, el efecto de mezclar la IA de otra empresa puede verse distinto (una entrada anterior (en inglés) mostró una tendencia distinta con código real).
A partir de estos resultados, así pienso usarlo yo.
- En lugar de más revisores, prueba a añadir enfoques distintos. En esta única ejecución, architecture y test plantearon cada uno un problema que nadie más encontró. Eso sí, no probé una configuración con varios revisores general, así que no puedo llegar a decir que “funciona mejor que añadir más revisores general”
- Añade los especialistas con
when.paths. En las revisiones de código, se unen solo cuando cambian esas rutas - Cuantos más hallazgos, más triaje. dev-orchestra fusiona los duplicados (esta vez, 60 pasaron a 51), pero con los revisores no es “cuantos más, mejor”
Resumen
- Hay 5 roles (dirección, diseño, implementación, revisión, corrección). Solo de revisores puedes poner los que quieras
- Especifica los modelos como familia +
latest. Sigue a los modelos nuevos según salen y no se ejecuta con un nombre que no pueda confirmar - Con los model tiers, puedes dar a un rol un modelo más barato o una segunda opinión
- Los revisores tienen 8 enfoques. Reorganízalos con
reviewer add/set/remove config suggest-rolespropone especialistas de database, frontend y backend a partir de los nombres de archivo. No gasta tokens. Los especialistas se unen a las revisiones de código solo cuando cambian esas rutas, y a todas las revisiones de diseño- Medido una vez con 9 revisores: pasar de 2 a 6 encontró 2 problemas más, y pasar de 6 a 9 solo añadió hallazgos
- En esta ejecución, architecture y test plantearon cada uno un problema que nadie más encontró. Incluso con el mismo enfoque general, los resultados diferían mucho según el modelo
La próxima vez escribiré sobre cómo conectar tu propio agente (un LLM local) a dev-orchestra.
Todas las entradas de esta serie están en la lista de entradas de “dev-orchestra”.
GitHub: istb16/dev-orchestra (una estrella siempre se agradece)
Artículos relacionados
Comparamos los presets quality / standard / fast de dev-orchestra
Expandí los presets de configuración inicial de dev-orchestra, quality / standard / fast, en tres entornos (solo Claude Code, solo Codex y ambos) y los comparé. Resumo cómo cambian el modelo por rol, el número de revisores y cuánto se recorta el coste, y cuál conviene elegir.
Probando dev-orchestra con Codex
También instalé dev-orchestra en Codex. Funciona solo con Codex, pero si instalas Claude Code y Codex a la vez, pasa automáticamente a la configuración recomendada, en la que IAs de empresas distintas revisan el código. Al final resumo también las funciones y precauciones exclusivas de Codex.
He publicado dev-orchestra: diseño, implementación y revisión con varias IA a partir de una sola frase
Presentación de dev-orchestra, un plugin que funciona en Claude Code / Codex / Antigravity. Resumo qué puede hacer, en qué se diferencia del codex-plugin-cc oficial, por qué merece la pena usarlo incluso solo con Claude Code y también sus desventajas.