前言
上一篇比较了 dev-orchestra 的预设。 预设是一次性决定“整台机器把钱花在哪里”的东西。
这次我来写自己重新组合其中内容的方法。
- 每个角色(role)使用哪个 CLI、哪个模型
- 排多少个、什么侧重点的审查者
- 让
config suggest-roles提议适合仓库的领域专家角色
最后,我把故意埋了 bug 的改动交给 9 位审查者,测了测增加人数会带来什么变化。
本文内容均在 dev-orchestra 1.0.0 上验证过。最新信息请看配置文档。
dev-orchestra 已在 GitHub 上公开(MIT 许可证)。如果觉得有用,给个 star 我会很高兴。
步骤
1. 了解角色
dev-orchestra 有 5 个角色。
| 角色 | 配置中的名称 | 职责 |
|---|---|---|
| 指挥 | orchestrator | 决定需要哪些工序,并汇总结果 |
| 设计 | architect | 调研并撰写计划(只读) |
| 实现 | implementer | 根据计划编写代码和测试 |
| 审查 | reviewers | 在看不到彼此结果的情况下阅读同一份 diff(只读)。可以设置任意多个 |
| 修复 | review_fixer | 只修复在分诊中采纳的问题 |
审查者之外的 4 个角色各有 1 个,审查者则可以排任意多个。
2. 用“系列名 + latest”指定模型
在 dev-orchestra 的配置里,不写模型名称(带日期的 ID)。写的是系列名,以及“使用该系列的最新版”这个指定。
implementer:
  provider: claude
  model:
    family: opus        # 系列名
version: latest # 该系列的最新版这样一来,出了新模型也会无需修改配置就直接跟上。 每次运行时,它都会先向已安装的 CLI 确认“opus 的最新版是哪个”再使用,所以不会出现以为在用某个模型、其实那个模型名并不存在的情况。如果无法确认,它会停下来,而不是靠猜。
可用的系列名可以通过 dev-orchestra model list 查看。我这里的输出如下(节选)。
claude: installed
  fable                        family=fable                source=cli-help
  opus                         family=opus                 source=cli-help
  sonnet                       family=sonnet               source=cli-help
codex: installed
  CLI default (recommended coding model) family=recommended-coding   source=cli-default
  GPT-6.1-Sol                  family=gpt-6.1-sol          source=cli-catalog
  GPT-6-Astra                  family=gpt-6-astra          source=cli-catalog
如果确实想固定为某一个模型,也可以写
version: pinned和 ID。不过这样就不会再跟随新模型了,所以请在有意为之时使用。
3. 按角色更换 CLI 或模型
重新组合最简单的办法是交给智能体去做。后台运行的是这样的命令。
| 你的请求 | 运行的命令 |
|---|---|
| “实现用 Claude 的 opus” | config set implementer.model.family opus |
| “设计交给 Codex 来做” | config set architect.provider codex(+ Codex 能接受的系列名) |
| “只对这个项目修改” | 在写入的命令上加 --scope project |
设置按项目 → 全局 → 内置默认值的顺序生效。也就是在预设之上,只覆盖想改的地方。
4. 给一个角色配上便宜的模型和第二意见
使用 model tier(模型层级),可以给一个角色配上其他模型作为备选。
implementer:
  provider: claude
  model:
    family: opus
    version: latest
  model_tiers:
    light:                 # 一行修改之类的事用便宜的模型
      model:
        family: sonnet
        version: latest
    second-opinion:        # 再让另一家公司的 AI 看一遍
provider: codex用哪个层级,由编排器根据请求的难度来选择(run implementer --tier light)。
指定了不存在的层级会报错,不会悄悄地用默认模型去跑。
5. 选择审查者的侧重点
每个审查者都有一个侧重点(role)。即使是同一份 diff,侧重点不同,关注的地方也不同。
| 侧重点 | 主要关注的内容 |
|---|---|
general | 正确性、边界情况、错误处理等整体方面 |
security | 认证与授权、注入、机密信息的处理 |
performance | 计算复杂度、N+1 查询、不必要的 I/O |
test | 针对改动行为的测试、没有意义的断言 |
architecture | 职责划分、耦合度、与现有惯例的一致性 |
database | 迁移的安全性、锁、约束、索引 |
frontend | 状态处理、渲染、无障碍 |
backend | API 契约、校验、状态码 |
添加、删除、修改审查者的方法如下(这些同样可以交给智能体)。
dev-orchestra reviewer add --provider codex --role security   # add a Codex security reviewer
dev-orchestra reviewer set 2 --provider codex --role general  # replace the 2nd one
dev-orchestra reviewer remove performance                     # remove
dev-orchestra reviewer list                                   # check
用 reviewer set <id> --when high-risk,还可以让某个审查者只在有风险的改动时才运行。
6. 让 config suggest-roles 提议领域专家角色
这是我这次最想介绍的功能。
config suggest-roles 会查看仓库的文件名,判断是否需要 database、frontend、backend 的专家角色。它不会调用模型,所以不消耗 token。
为了写这篇文章,我做了一个带前端、API 和数据库迁移的小型 TODO 应用仓库来试了试。
Proposed:
  claude-database  claude / sonnet  role database
    when.paths: migrations/*, */migrations/*, *.sql
    evidence: migrations/: 2 files, e.g. db/migrations/001_create_users.sql, db/migrations/002_create_todos.sql
  claude-frontend  claude / sonnet  role frontend
    when.paths: *.tsx
    evidence: *.tsx: 2 files, e.g. frontend/src/TodoItem.tsx, frontend/src/TodoList.tsx
  claude-backend  claude / sonnet  role backend
    when.paths: api/*, */api/*, routes/*, */routes/*
    evidence: api/: 3 files, e.g. api/db.py, api/routes/todos.py, api/routes/users.py
Each joins only code rounds touching its paths, and every design review round.
连**为什么提议它(evidence)**也会给出来。
另一方面,在这个博客的仓库(Astro)上运行,则什么也没有提议。
Not proposed:
  database: no signal (no migrations/, migrate/, alembic/ or prisma/ directory; fewer than 2 *.sql files; no schema.prisma)
  frontend: no signal (fewer than 2 *.tsx, *.jsx, *.vue or *.svelte files)
  backend: no signal (no api/, server/, backend/, handlers/, routes/ or controllers/ directory holding 2 files outside a frontend)
Nothing to add.没有提议的理由也会显示,所以不会纠结“为什么没有加”。
接受提议时加上 --write。项目的配置文件(.dev-orchestra.yaml)里被添加了如下内容。
reviewers_extra:
  - id: claude-database
    provider: claude
    model:
      family: sonnet
      version: latest
    role: database
    when:
      paths:
        - "migrations/*"
        - "*/migrations/*"
        - "*.sql"
关键在于 when.paths。专家角色在代码审查中只有当这些路径下的文件发生变化时才会加入。只改 CSS 的时候不会叫上 database 的负责人,所以平时的代码审查不会变重。
不过,正如输出最后一行所说,设计审查每次都会有专家加入。设计审查的费用会相应增加。
| 预设 | suggest-roles | |
|---|---|---|
| 决定什么 | 整台机器的花钱方式 | 添加适合仓库的专家 |
| 保存位置 | 全局配置 | 项目配置 |
| 生效时机 | 始终 | 代码审查只在这些路径变化时;设计审查每次 |
7. 实测增加审查者会带来什么变化
最后,我测了审查者人数不同时结果会怎样变化。
方法
- 在上面的 TODO 应用上,做了一个故意埋了 6 个 bug 的改动(4 个文件)
- 用
quality预设(Claude 和 Codex 共 6 人),再加上suggest-roles的 3 位专家,共 9 人,只审查了一次 - 审查者之间看不到彼此的结果,所以“只有 1 人”“两家公司”等组合的结果,是把 9 人的结果组合起来统计的
- 所有指出的问题都由我自己分诊,分成埋下的 bug(B1~B6)和没埋但确实存在的问题(E1~E6)
| 埋下的 bug | |
|---|---|
| B1 | 用 f-string 把搜索词拼进 SQL(SQL 注入) |
| B2 | 删除时不确认所有者(可以删掉别人的 TODO) |
| B3 | 分页的 offset 加了 + 1(错位 1 条) |
| B4 | 添加了没有默认值的 NOT NULL 列(迁移会失败) |
| B5 | 用 dangerouslySetInnerHTML 显示标题(XSS) |
| B6 | 删除的测试没有验证所有者确认 |
结果
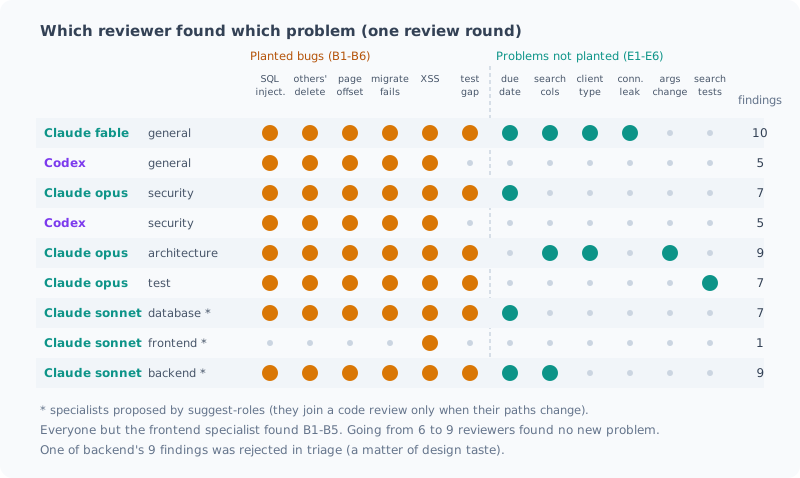
按组合汇总,结果如下。
| 组合 | 发现的问题(共 12 个) | 指出的问题数(合并重复之前) |
|---|---|---|
| Claude fable(general)1 人 | 10 | 10 |
| Codex(general)1 人 | 5 | 5 |
| 两家公司(上面的 2 人) | 10 | 15 |
quality 的 6 人 | 12 | 43 |
| 6 人 + 3 位专家 | 12 | 60 |
得到的结论
- 显而易见的 bug 几乎所有人都发现了。B1~B5 被除 frontend 专家(侧重点是前端)之外的 8 人全部发现
- 从 2 人增加到 6 人,发现的问题多了 2 个(10 → 12)。多出来的是 E5 和 E6
- 从 6 人增加到 9 人,问题没有增加,只是指出的问题数增加了。6 人就发现了全部 12 个,9 人时指出的问题数从 43 条变成了 60 条。dev-orchestra 合并重复后,60 条变成了 51 条
- 差别出现在未埋下的问题上。“函数参数变了导致调用方出错”(E5)只有 architecture 侧重点发现了,“没有搜索的测试”(E6)只有 test 侧重点发现了
- 模型之间的差距也很大。同样是 general 侧重点,Claude fable 一人就发现了 12 个中的 10 个,而 Codex 是 5 个。这次没能把模型的差异和侧重点的差异分开
- 2 位 Codex 审查者发现了 5 个埋下的 bug,且没有误报,但这次没有提出其他人没发现的问题
- 9 人的费用合计约 11 万 token(因为 diff 只有 4 个文件,很小)
这只是一次、小样本的结果。埋下的 bug 都是显而易见的,把未埋下的问题当作“真实问题”也是我自己的判断。在实际开发中更复杂的改动上,混入其他公司 AI 的效果可能会不一样(之前的文章(英文)里,在真实代码上就出现了不同的倾向)。
根据这些结果,我自己的用法是这样想的。
- 与其增加人数,不如试着增加不同的侧重点。在这一次里,architecture 和 test 各提出了 1 个其他人没发现的问题。不过我没有试过并排好几个 general 的组合,所以还说不到“比增加同样的 general 更有效”
- 专家角色要带
when.paths添加。在代码审查中,只有这些路径变化时才会加入 - 指出的问题越多,分诊的工作量就越大。dev-orchestra 会帮忙合并重复(这次 60 条变成了 51 条),但审查者的人数并不是“越多越好”
总结
- 角色有 5 个(指挥、设计、实现、审查、修复)。只有审查者可以排任意多个
- 模型用系列名 +
latest指定。它会直接跟上新模型,无法确认的名称不会运行 - 用 model tier,可以给一个角色配上便宜的模型或第二意见
- 审查者有 8 种侧重点。用
reviewer add/set/remove重新组合 config suggest-roles根据文件名提议 database、frontend、backend 的专家角色。不消耗 token。专家在代码审查中只有这些路径变化时才加入,在设计审查中每次都加入- 用 9 人只测了一次:从 2 人到 6 人多发现了 2 个问题,从 6 人到 9 人只是指出的问题数增加了
- 在这一次里,architecture 和 test 各提出了 1 个其他人没发现的问题。即使同样是 general 侧重点,不同模型之间也有很大差距
下一篇,我会写如何把自己做的智能体(本地 LLM)接入 dev-orchestra。
本系列的文章可以在“dev-orchestra”的文章列表中集中阅读。
GitHub: istb16/dev-orchestra(给个 star 会是很大的鼓励)
相关文章
比较 dev-orchestra 的预设 quality / standard / fast
我在 3 种环境(只有 Claude Code、只有 Codex、两者都有)中实际展开了 dev-orchestra 初始设置里可选的预设 quality / standard / fast,并进行了比较。这里总结各角色的模型、审查者人数和成本削减程度有何不同,以及该选哪一个。
在 Codex 上安装并试用 dev-orchestra
我把 dev-orchestra 也装到了 Codex 上。只有 Codex 也能运行,但同时安装 Claude Code 和 Codex 后,会自动变成由不同公司的 AI 来审查代码的推荐配置。文末还整理了只有 Codex 才有的功能和注意事项。
我公开了 dev-orchestra:一句话跑完设计、实现和多 AI 评审
介绍可在 Claude Code / Codex / Antigravity 中运行的插件 dev-orchestra。内容包括它能做什么、与官方 codex-plugin-cc 的区别、只用 Claude Code 也值得使用的原因,以及它的缺点。