Hacer revisar el código a varias IA a mano era un fastidio, así que hice un plugin que lo automatiza
Introducción
Hice un plugin para Claude Code / Codex llamado dev-orchestra y publiqué la versión 1.0.0.
Le haces una petición de una sola frase y recorre en orden el diseño → la implementación → las pruebas → revisiones independientes por varias IA → la clasificación de los hallazgos → las correcciones → las pruebas de nuevo.
La explicación detallada de lo que puede hacer la dejo para el siguiente artículo. Aquí escribo sobre por qué lo hice y cómo me fue después de hacerlo y usarlo.
dev-orchestra está publicado en GitHub (licencia MIT). Si te parece útil, me alegraría que le dieras una estrella.
Antes: yo me había convertido en el mensajero
Desde que empecé a hacer que la IA escribiera código, había una cosa que me inquietaba. A la IA se le da mal revisar el código que ella misma escribió. Al revisar sigue teniendo las mismas suposiciones que produjeron el bug.
Así que empecé a hacer que otra IA también revisara el código. Esto es lo que hacía:
- Hacer que el agente de la terminal A lo implemente
- Copiar el diff y pedir a los agentes de las terminales B y C que lo revisen
- Esperar a que terminen
- Copiar los resultados de vuelta a la terminal A y hacer que corrija
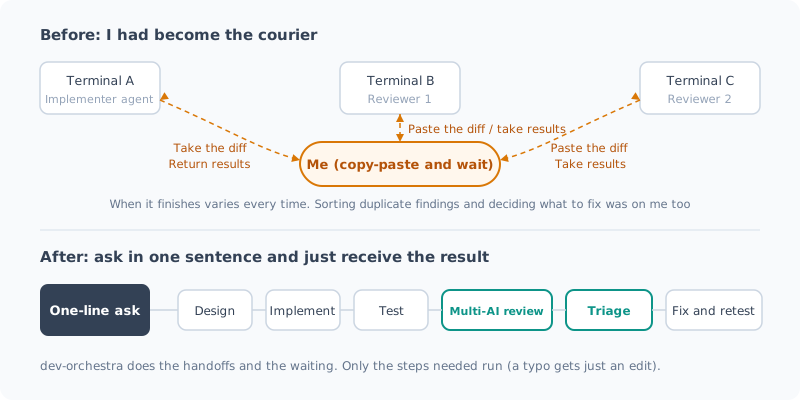
Resultó más tedioso de lo que imaginaba.
- Cada vez tarda un tiempo distinto en terminar. A veces vuelve en decenas de segundos y a veces tarda varios minutos. Mientras tanto, lo único que puedo hacer es esperar
- Cuantos más revisores añado, más idas y venidas de copiar y pegar hay
- Los hallazgos que vuelven están duplicados o fuera de lugar. Tengo que clasificar yo mismo cuáles corregir antes de devolverlos
En otras palabras, se suponía que estaba haciendo que la IA trabajara, pero me había convertido en el mensajero entre IA.
¿Valía la pena mostrárselo a otra IA?
Seguí con ello a pesar del esfuerzo porque se notaba que daba resultado.
Lo comprobé con números un poco más tarde. Cuando estuvo lista la versión inicial de dev-orchestra, escribí sobre una ejecución con ella en un artículo anterior (en inglés). Hice que tres IA revisaran un script que yo había escrito y que ejecutaba yo mismo (1418 líneas), y encontraron 11 bugs reales. Tres de ellos eran de los que yo casi seguro nunca habría notado.
Eso sí, es el resultado de una sola ejecución. El tercer revisor (un LLM local) acertó solo 1 de 6, y hubo también defectos que las tres IA pasaron por alto. Mostrar el código a varias IA no lo vuelve perfecto.
Aun así, era claramente mejor que «hacer que una IA lo escriba y dar por terminado». El problema no era el efecto, sino el esfuerzo.
Lo que hice: dev-orchestra
Así que hice que se pudiera delegar por completo el trabajo de mensajero. Basta con hablarle a tu agente como de costumbre.
この issue を設定済みのワークフローで実装してEntonces dev-orchestra elige solo los pasos que necesita la petición y los ejecuta en orden.
| Paso | Qué hace |
|---|---|
| Diseño | Investiga y escribe un plan. No pasa a la implementación hasta que lo apruebas |
| Implementación | Escribe el código y las pruebas a partir del plan |
| Revisión | Dos o más IA leen el mismo diff sin ver los resultados de las demás |
| Clasificación | Une los duplicados y distingue qué hallazgos son reales |
| Corrección | Corrige solo los hallazgos aceptados y vuelve a ejecutar las pruebas |
Si es un typo, solo se edita; si es un cambio de especificación, se hace todo: los pasos cambian según el tamaño de la petición.
Lo que funcionó bien
1. La clasificación da en el punto justo
Esto fue lo que más ayudó.
Cuando varias IA revisan el código, los hallazgos se solapan y algunos están fuera de lugar. Si se los pasas todos con un «corrige esto», acabas con un montón de cambios innecesarios.
dev-orchestra une de forma mecánica los hallazgos duplicados y después la IA orquestadora los clasifica en aceptados, rechazados y duplicados. Al corrector solo llegan los hallazgos aceptados. Esta clasificación queda en el punto justo, con una sensación casi igual a la de hacerla yo mismo.
2. La implementación ganó precisión
No lo medí ni lo comparé; es mi impresión. Desde que ejecuto el diseño, la implementación y la revisión como pasos separados, siento que las implementaciones salen en general como pretendía.
Por ejemplo, incluso en una petición que era solo escribir código de pruebas, el resultado era mejor después de pasar por los pasos de revisión y corrección.
Lo que rehíce en tres semanas de trabajo real
Publiqué la 0.1.0 el 10/9 y la 1.0.0 el 12/10. Es más o menos un mes, pero en realidad trabajé en ello unas tres semanas. En ese tiempo saqué unas 30 versiones. Es el resultado de ir arreglando los «esto es un problema» mientras lo usaba. Estos son los que se me quedaron grabados.
| Lo que rehíce | Por qué |
|---|---|
| No adivinar nombres de modelo | Evita creer que se ejecutó cuando usó un nombre de modelo que no existe. La configuración solo contiene el nombre de la familia y «latest» |
| Congelar el diff que se revisa | Si todos no miran lo mismo, no se pueden comparar los hallazgos |
| La segunda revisión cubre solo las correcciones | Mostrarlo todo de nuevo cada vez duplica tanto el tiempo como los tokens |
| Menos revisores para cambios pequeños | Tres revisores para un typo es un desperdicio |
| Esperar la aprobación del plan | Si el diseño se desvía y se sigue hasta la implementación, rehacerlo cuesta mucho |
| Forzar el modo de solo lectura en la CLI | Pedir simplemente «no modifiques nada» a veces no se respetaba |
El problema: los tokens se acaban rápido
Lo que más me costó mientras lo construía fue que cada ejecución cuesta dinero (tokens).
Como ejecuta varias IA a través de las CLI reales, los tokens se agotan rápido incluso cuando solo pretendía lanzar una prueba. Llegué al límite varias veces y el trabajo se detuvo.
Por eso fui añadiendo poco a poco mecanismos para no llamar a las IA innecesariamente, como «la segunda revisión cubre solo las correcciones» y «menos revisores para cambios pequeños» de la tabla anterior.
Aun así, no creo que sea suficiente todavía. Hacer más eficiente el uso de tokens es el mayor reto después de la 1.0.0.
Pruébalo si quieres
En Claude Code se instala con dos líneas.
claude plugin marketplace add istb16/dev-orchestra
claude plugin install dev-orchestra@dev-orchestra
También funciona con Codex. Lo que puede hacer y con qué configuraciones se puede usar está explicado en el artículo de presentación.
Como ejecuta varias IA, consume más tokens que arreglárselas con una sola. Te recomiendo empezar con peticiones pequeñas.
Resumen
- Hacer que otra IA revise el código que escribió una IA encuentra bugs que tú no notarías
- Pero a mano, copiar y pegar entre terminales y esperar me convirtió en el mensajero
- dev-orchestra es lo que me permite delegar eso. Una petición de una sola frase ejecuta todo, desde el diseño hasta la revisión y las correcciones
- Lo que funcionó bien: la clasificación da en el punto justo, y sentí que la implementación (incluso solo las pruebas) ganó precisión (mi impresión)
- El problema: el consumo de tokens. La eficiencia es el reto después de la 1.0.0
- La 1.0.0 en unas tres semanas de trabajo real. Pruébalo si quieres
Todos los artículos de esta serie están en la lista de artículos de «dev-orchestra».
GitHub: istb16/dev-orchestra (una estrella me animaría mucho)
Artículos relacionados
Reorganizando los revisores y los roles de dev-orchestra
Cómo indicar el modelo de cada rol de dev-orchestra, cómo elegir los enfoques de los revisores y config suggest-roles, que propone especialistas de dominio. También le mostré a 9 revisores un cambio con bugs plantados a propósito para medir qué cambia al aumentar su número.
Comparamos los presets quality / standard / fast de dev-orchestra
Expandí los presets de configuración inicial de dev-orchestra, quality / standard / fast, en tres entornos (solo Claude Code, solo Codex y ambos) y los comparé. Resumo cómo cambian el modelo por rol, el número de revisores y cuánto se recorta el coste, y cuál conviene elegir.
Probando dev-orchestra con Codex
También instalé dev-orchestra en Codex. Funciona solo con Codex, pero si instalas Claude Code y Codex a la vez, pasa automáticamente a la configuración recomendada, en la que IAs de empresas distintas revisan el código. Al final resumo también las funciones y precauciones exclusivas de Codex.