前言
我做了一个面向 Claude Code / Codex 的插件 dev-orchestra,并发布了 1.0.0。
你只需用一句话提出需求,它就会依次完成设计 → 实现 → 测试 → 多个 AI 的独立评审 → 整理评审意见 → 修复 → 重新测试。
关于它能做什么的详细说明,我留到下一篇文章。这篇文章写的是我为什么要做它,以及做出来用过之后感觉如何。
dev-orchestra 已在 GitHub 上公开(MIT 许可证)。如果你觉得有用,希望你能给它点个 Star,我会很高兴。
做之前:我成了搬运工
自从开始让 AI 写代码,有件事一直让我在意。 AI 不擅长评审自己写的代码。 因为评审时,它仍然带着当初产生 bug 的那些前提。
所以我开始让另一个 AI 也来评审代码。 我当时做的是这样的事:
- 让终端 A 里的智能体去实现
- 复制 diff,请终端 B 和 C 里的智能体评审
- 等它们完成
- 把结果复制回终端 A,让它修复
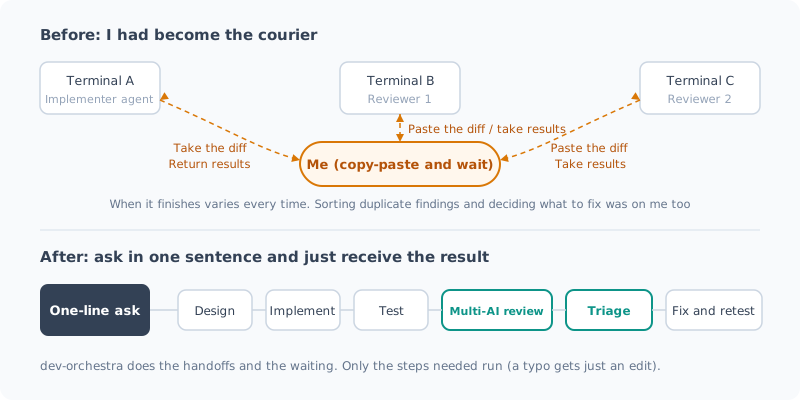
这比我想象的要麻烦得多。
- 每次完成的时间都不一样。 有时几十秒就返回,有时要花好几分钟。这期间我只能干等
- 评审者越多,复制粘贴的来回就越多
- 返回的意见里有重复的,也有跑题的。我得先自己筛选出该修哪些,再交回去
也就是说,明明是在让 AI 干活,我却成了 AI 之间的搬运工。
给另一个 AI 看,有意义吗
我不嫌麻烦地坚持做下去,是因为确实有手感。
用数字验证是稍后的事了。dev-orchestra 的早期版本做出来之后,我把用它跑出来的结果写在了之前的文章(英文)里。我让 3 个 AI 评审了一个我自己写、自己在跑的脚本(1418 行),发现了 11 个真实存在的 bug。其中 3 个是我自己基本不可能发现的。
不过,这只是一次运行的结果。第三个评审者(本地 LLM)6 个里只命中了 1 个,还有三个 AI 全都漏掉的缺陷。让多个 AI 来看,并不等于万无一失。
即便如此,也明显好过“让一个 AI 写完就结束”。 问题不在效果,而在麻烦。
做出来的东西:dev-orchestra
于是我让它能把搬运工的活整个接过去。 你只要像平时一样跟智能体说话就行。
この issue を設定済みのワークフローで実装して然后 dev-orchestra 只挑选这个需求所需的步骤,依次运行。
| 步骤 | 做什么 |
|---|---|
| 设计 | 调研并写出计划。在你批准之前不会进入实现 |
| 实现 | 根据计划编写代码和测试 |
| 评审 | 两个以上的 AI 互不查看对方的结果,各自阅读同一份 diff |
| 分诊 | 合并重复项,判断哪些意见是真问题 |
| 修复 | 只修复被采纳的意见,并重新运行测试 |
改个 typo 就只做编辑,改规格就全部走一遍:步骤会随需求的大小而变化。
用下来觉得好的地方
1. 分诊恰到好处
这是最见效的一点。
让多个 AI 评审时,意见会有重复,也会混进跑题的。把它们全部丢给 AI 说“修一下”,就会产生一堆不必要的改动。
dev-orchestra 先机械地合并重复的意见,再由担任编排者的 AI 把它们分为采纳、驳回、重复。到达修复者手里的只有被采纳的意见。 这个分类恰到好处,感觉和我自己来做几乎一样。
2. 实现的精度提高了
这不是经过测量对比得出的,而是体感。 自从把设计、实现、评审拆开来依次运行后,我觉得实现大体都能做成我想要的样子。
比如,即使只是一个只让它写测试代码的需求,经过评审和修复这几个步骤之后,成品也更好。
实际工作 3 周里重做的东西
0.1.0 是 9/10 发布的,1.0.0 是 10/12。时间跨度大约一个月,但我实际动手的只有大约 3 周。这期间我发布了大约 30 个版本。 这是边用边把“这里不好用”逐个解决的结果。下面列出让我印象深刻的几项。
| 重做的内容 | 原因 |
|---|---|
| 不猜测模型名 | 避免用了不存在的模型名,却以为已经运行过。配置里只写系列名和“latest” |
| 冻结被评审的 diff | 如果大家看的不是同一份东西,就没法比较意见 |
| 第二次评审只看修改的部分 | 每次都全部重新给它们看,时间和 token 都会翻倍 |
| 小改动减少评审者 | 一个 typo 动用 3 个人太浪费 |
| 等待计划批准 | 设计跑偏了还一路做到实现,返工就很大 |
| 用 CLI 强制只读 | 只是请求“不要改动”,有时并不会被遵守 |
遇到的难题:token 很快就用完
做的过程中最头疼的是,每次运行都要花钱(token)。
因为是用真正的 CLI 来运行多个 AI,所以哪怕只是想测试一下,token 也会飞快地减少。我好几次撞到上限,工作就停了下来。
于是,我陆续加入了一些避免白白调用 AI 的机制,比如上表中的“第二次评审只看修改的部分”和“小改动减少评审者”。
不过,我还觉得远远不够。让 token 的使用更高效,是 1.0.0 之后最大的课题。
欢迎试用
在 Claude Code 里,两行命令就能安装。
claude plugin marketplace add istb16/dev-orchestra
claude plugin install dev-orchestra@dev-orchestra
Codex 也能用。它能做什么、可以搭配怎样的配置,我整理在了介绍文章里。
由于要运行多个 AI,token 的消耗会比只用一个 AI 更多。建议先从小的需求开始试。
总结
- 让另一个 AI 也来评审 AI 写的代码,能发现自己注意不到的 bug
- 但手工操作时,在终端之间复制粘贴和等待让我成了搬运工
- 能把这件事交出去的就是 dev-orchestra。一句话的需求,就能从设计一路跑到评审和修复
- 好的地方是分诊恰到好处,以及我感觉实现(哪怕只是测试)的精度提高了(体感)
- 难题是 token 消耗。提升效率是 1.0.0 之后的课题
- 实际工作大约 3 周就做出了 1.0.0。欢迎试用
这个系列的文章可以在“dev-orchestra”文章列表里集中阅读。
GitHub: istb16/dev-orchestra(如果能给个 Star,对我会是很大的鼓励)
相关文章
重新组合 dev-orchestra 的审查者与角色
介绍如何为 dev-orchestra 的每个角色(role)指定模型、如何选择审查者的侧重点,以及能提议领域专家角色的 config suggest-roles。我还把故意埋了 bug 的改动交给 9 位审查者,测了测增加人数会带来什么变化。
比较 dev-orchestra 的预设 quality / standard / fast
我在 3 种环境(只有 Claude Code、只有 Codex、两者都有)中实际展开了 dev-orchestra 初始设置里可选的预设 quality / standard / fast,并进行了比较。这里总结各角色的模型、审查者人数和成本削减程度有何不同,以及该选哪一个。
在 Codex 上安装并试用 dev-orchestra
我把 dev-orchestra 也装到了 Codex 上。只有 Codex 也能运行,但同时安装 Claude Code 和 Codex 后,会自动变成由不同公司的 AI 来审查代码的推荐配置。文末还整理了只有 Codex 才有的功能和注意事项。