前言
上一篇写了我为什么要做 dev-orchestra。 这一篇来介绍它能做什么,适合哪些人。
- GitHub:istb16/dev-orchestra(MIT,1.0.0)
- 运行环境:作为 Claude Code / Codex / Antigravity 的插件
在这个系列里,之后我会依次介绍在 Claude Code、Codex、Antigravity 中各自的用法,以及配置的详细内容。这篇文章是入口。
dev-orchestra 已在 GitHub 上公开(MIT 许可证)。如果觉得有用,给个 Star 我会很开心。
一句话概括
它是一个插件:只需一句话的请求,就能跑完设计 → 实现 → 测试 → 多个 AI 的独立评审 → 评审意见的分拣 → 修复 → 重新测试的全过程。
Implement this issue with the configured workflow对它这样说一句,dev-orchestra 就会只挑出请求所需的步骤,按顺序分配给各个 AI。
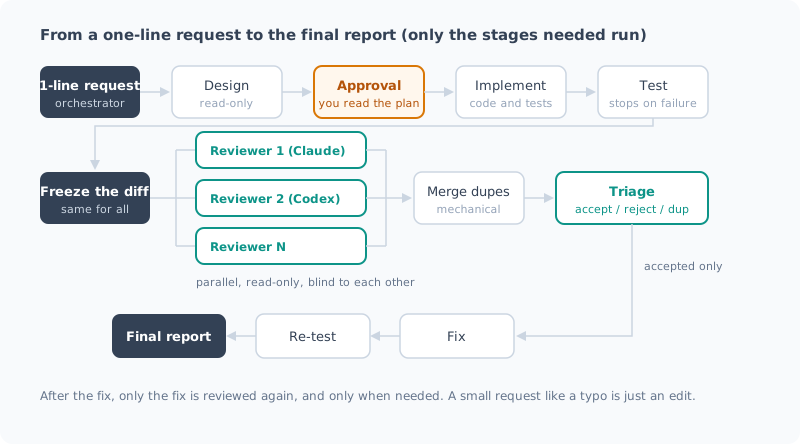
| 步骤 | 负责角色 | 要点 |
|---|---|---|
| 设计 | architect | 调查并撰写计划。只读,在你批准之前不会进入实现 |
| 实现 | implementer | 根据计划编写代码和测试 |
| 评审 | reviewers | 两个以上的 AI 在彼此看不到对方结果的情况下,阅读冻结后的同一份差异 |
| 分拣 | orchestrator | 合并重复项,把意见分为采纳、驳回和重复 |
| 修复 | review_fixer | 只修复被采纳的意见 |
改个 typo 只需编辑,改动 schema 则全部走一遍:实际运行哪些步骤,取决于请求的大小。
为什么要让另一个 AI 来评审
AI 不擅长评审自己写的代码。 导致 bug 的那些想当然的假设,在评审时依然原封不动地存在。
在互不知道对方意见的情况下查看同一份差异的不同 AI,有时会意见不一致。 这种分歧所在之处,就是真正的 bug 所在。
另一个重要的点是不要把评审结果原样交给修复环节。 多个 AI 的意见会有重复,也会混进一些不着边际的内容。如果统统丢给它一句“都改掉”,就会产生大量不必要的改动。 因此 dev-orchestra 会先机械地整理这些意见,再进行分拣,只把被采纳的交给负责修复的角色。
与官方 codex-plugin-cc 的区别
如果只是想“从 Claude Code 里让 Codex 做评审”,OpenAI 官方有 codex-plugin-cc。 在上手简便程度上它更胜一筹,所以我老实地把区别列出来。
| codex-plugin-cc | dev-orchestra | |
|---|---|---|
| 提供方 | OpenAI 官方 | 个人开源项目 |
| 运行环境 | Claude Code | Claude Code / Codex / Antigravity |
| 负责评审的 AI | Codex | 两个以上并行(Claude / Codex / 自定义。Antigravity 为有限支持) |
| 覆盖范围 | 评审,以及把任务委派给 Codex | 从设计到评审、修复、重新测试一气呵成 |
| 意见的处理 | 把结果返回给 Claude Code。启用可选的 review gate 后,发现问题会让 Claude 处理 | 合并重复项 → 分拣 → 只修复被采纳的 |
| 上手难易 | 用斜杠命令即可立即使用 | 要先选择预设 |
| 便利功能 | 后台运行、可指定关注点的批判性评审、把对话交接给 Codex | 计划审批、评审往返次数上限、token 记录 |
官方插件的 review gate 可以用 /codex:setup --enable-review-gate 启用。
当 Claude 即将结束回复时,Codex 会进行评审,如果发现问题,就阻止其结束,让 Claude 先修复。如果只是想自动评审并让它修复,这样就足够了。
README 中提醒,review gate 可能会不断往返,耗尽你的使用额度。
区别在于评审者的数量和意见的处理方式。review gate 的评审者只有 Codex 一个。dev-orchestra 会对照多个评审者的意见,合并重复项并进行分拣,只修复被采纳的。
选择时可以参考下面的标准。
- 想给 Claude Code 的工作加上一个 Codex 的第二意见 → codex-plugin-cc
- 想用多个 AI 跑完整个开发流程 → dev-orchestra
支持的 CLI
dev-orchestra 直接使用你手头已安装的 AI CLI。不需要 API 密钥(使用各 CLI 的登录状态)。
| Claude Code | Codex | Antigravity | |
|---|---|---|---|
| 作为插件安装 | ○ | ○ | ○(通过链接安装,需要重启) |
| 实现、修复角色 | ○ | ○ | ○(要运行测试需要配置) |
| 设计、评审角色 | ○ 由 CLI 强制只读 | ○ 只读沙箱 | △ 无法强制只读,所以是带警告的有限支持 |
| 从设计的中断处恢复 | ○ | ○ | × |
Claude Code 和 Codex 可以胜任所有角色。 Antigravity 适合实现和修复,也可以放在设计或评审的位置,但那样它会在可修改文件的状态下运行。 详细的区别,我会在各工具的使用篇中介绍。
只用 Claude Code 也有意义吗
一说“多个 AI”,对只用 Claude Code 的人来说似乎与己无关。 但是,只用 Claude Code 也是有意义的。
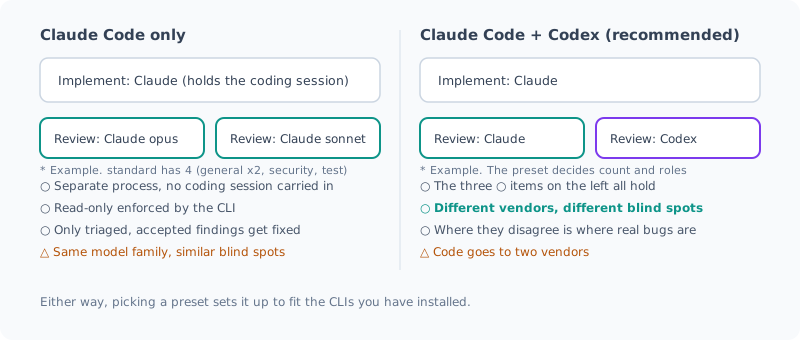
| 只用 Claude Code 也能得到的 | 为什么有效 |
|---|---|
| 评审者在独立进程中运行,不会带入实现时的对话 | 读代码时没有“刚才是我自己这么决定的”这种前提 |
| 只读由 CLI 强制 | 光是拜托“不要改动”,有时并不会被遵守 |
| 可以为每个角色分配不同的模型 | 设计用强模型,想省钱的评审用轻量模型,花钱可以有轻有重 |
| 通过分拣只修复被采纳的意见 | 不会混入不必要的修改 |
只运行必要的步骤,记录保存在 .ai/ 中 | 小请求保持轻量,大请求则可以事后回看计划和评审 |
选择预设后,会根据那台机器上已安装的 CLI 来决定配置。如果只安装了 Claude Code,评审者也只会由 Claude 组成。
话虽如此,最有效的是混入其他厂商的 AI。同一系列的模型,想当然的假设也容易相似。 如果你也能用 Codex,请务必试试两家厂商的配置。
优点和缺点
| 优点 | 缺点 |
|---|---|
| 能发现自己注意不到的 bug | 运行时间和 token 消耗会增加(因为要多次调用 AI) |
| 不再需要当搬运工(复制粘贴和等待) | 评审意见仍需分拣(由 orchestrator 来做,但最后确认的是你) |
| 不会混入不必要的修改 | 评审者读到的代码会被发送给你登记的各个厂商(不一定只是差异) |
| 计划和评审的记录会保留下来 | 有一点引入的麻烦,比如要先选择预设 |
尤其请留意第三个缺点。 如果用 Claude 和 Codex 来评审,代码会同时发送给 Anthropic 和 OpenAI。
被发送的不只是差异。为了调查差异周围的内容,评审者可以读取仓库内的文件。即使是只读,Claude 和 Codex 也都能读到 .env 之类的文件。而且对 Claude 来说,你自己写的 permissions.deny 对评审者同样不起作用。原因和对策(把规则移到 managed settings),我会在下一篇 Claude Code 的文章里写。
如果要处理不能外传的代码,也可以只用本地 LLM 来组建评审。
但这时,请不要从 Claude Code 等云端 AI 来调用 dev-orchestra。调用方的 AI 自己会读取代码,代码就会从那里流向云端。请直接在终端中运行,并用 --only 把评审者限定为本地 LLM。详细内容我写在了之前的文章(英文)里。
虽然内置了抑制 token 消耗的机制(小改动减少评审者、第二次评审只看修复部分等),但肯定比只用一个 AI 要多。建议先从小请求开始尝试。
使用方法
在 Claude Code 中,安装只需两行。
claude plugin marketplace add istb16/dev-orchestra
claude plugin install dev-orchestra@dev-orchestra
在 Codex 和 Antigravity 中如何安装、初始设置以及各个命令的说明,都整理在 GitHub 的文档里。最新信息以这里为准。
- README — 安装、初始设置、使用方法
- Workflow — 各步骤做什么,工作流示例
- Configuration — 预设、模型、评审者的组合方式
总结
- dev-orchestra 是一个插件,能从一句话的请求出发,跑完设计、实现、多个 AI 评审和修复
- 评审者只读、互不查看,阅读冻结后的同一份差异。意见会经过分拣,只修复被采纳的
- 想加一个 Codex 的第二意见,用官方的 codex-plugin-cc;想跑完整个开发流程,用 dev-orchestra
- Claude Code 和 Codex 可以胜任所有角色,Antigravity 适合实现和修复(设计、评审为有限支持)
- 只用 Claude Code 也有意义,因为有独立进程的评审和分拣。混入其他厂商时效果最好
- 缺点是时间和 token,以及代码会被发送给各个厂商。评审者还能读取差异之外的文件
- 机密代码请直接在终端中、只用本地 LLM 来评审
下一篇开始,我会在 Claude Code、Codex、Antigravity 中分别实际使用它。
这个系列的文章都收录在“dev-orchestra”文章列表中。
GitHub:istb16/dev-orchestra(给个 Star 对我是莫大的鼓励)
相关文章
重新组合 dev-orchestra 的审查者与角色
介绍如何为 dev-orchestra 的每个角色(role)指定模型、如何选择审查者的侧重点,以及能提议领域专家角色的 config suggest-roles。我还把故意埋了 bug 的改动交给 9 位审查者,测了测增加人数会带来什么变化。
比较 dev-orchestra 的预设 quality / standard / fast
我在 3 种环境(只有 Claude Code、只有 Codex、两者都有)中实际展开了 dev-orchestra 初始设置里可选的预设 quality / standard / fast,并进行了比较。这里总结各角色的模型、审查者人数和成本削减程度有何不同,以及该选哪一个。
在 Codex 上安装并试用 dev-orchestra
我把 dev-orchestra 也装到了 Codex 上。只有 Codex 也能运行,但同时安装 Claude Code 和 Codex 后,会自动变成由不同公司的 AI 来审查代码的推荐配置。文末还整理了只有 Codex 才有的功能和注意事项。